Операційна модель контексту та довгі завдання
Сьогодні два великі кроки.
У першій частині розберемося, що Claude взагалі знає в момент відповіді: не "пам'ять про проєкт", а конкретне робоче вікно, яким можна керувати.
У другій - як вести роботу, що довша за один підхід: рефакторинг, нову feature або маленький проєкт з нуля, з контрольними точками, відкатом через Git і паралельними сесіями.
Рівень 5. Операційна модель контексту
Рівень 6. Довгі завдання
Міф "Claude все пам'ятає"
Claude бачить не "пам'ять про проєкт", а поточне вікно контексту: прочитали файл - він у вікні; нічого не завантажили - для моделі це порожнеча. Вікно складається з кількох шарів.
- поточний діалог;
- прочитані файли;
- вивід команд і логи;
CLAUDE.md, rules і auto memory;- виділення з IDE;
- службовий шар: system prompt, описи інструментів і skills, імена MCP tools.
У вікна фіксований розмір, і він залежить від моделі. Точну цифру вашої сесії показує /context.
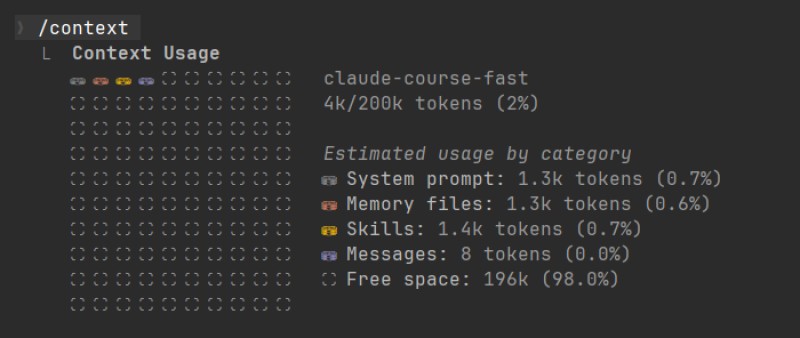
Але важливіше не число, а сам факт стелі: усі шари ділять вікно між собою, і місце, зайняте одним джерелом, уже не дістанеться іншому. Тому далі говоритимемо про контекст як про бюджет.
CLAUDE.md повертається сам і створює ілюзію, ніби Claude "пам'ятає проєкт". Насправді він каже, як поводитися в проєкті, але не зберігає, яку гіпотезу ви відхилили дві години тому. Тому нова сесія - не амнезія: правила повернуться, а деталей учорашнього розслідування немає, і повернути їх - роль task spec.
На схемі видно головне: сигнал потрапляє у вікно тільки через конкретне джерело, а не телепатією. Якщо ви нічого не поклали на стіл, для моделі цього просто немає.
Відбір контексту
"Подивись увесь проєкт і знайди проблему" - спокусливо, але зазвичай шкодить: зайвий контекст конкурує за увагу моделі, міркування пливе.
Що зазвичай реально допомагає завданню:
- короткий task spec;
- 1-3 точні файли;
- короткий лог або stack trace;
- потрібний тест;
- схожий зразок із проєкту.
А от увесь repository, логи за день і старі неперевірені гіпотези тільки засмітять вікно. Перед тим як додати файл, запитайте себе: "приберу це джерело - Claude працюватиме гірше чи просто зітхне з полегшенням?"
Верхня колонка дає моделі робочу опору, права - тільки конкурує за увагу. Хороший контекст не максимальний, а достатній.
Контекст, коли файлів ще немає
Операційна модель контексту не змінюється, навіть коли проєкту ще немає. Уявіть, що ви створюєте невеликий довідник локалей (коди країн і мов з деталями) з нуля: проєкт порожній, читати поки нічого. Контекст тоді збирається не з коду, а з вашого SPEC.md.
- що будуємо;
- який перший шматок робимо;
- які межі має завдання.
Правило достатнього мінімуму працює і тут: дайте spec і зразок стилю, а не "придумай усе сам".
SPEC.md, почніть із міні-спеки прямо в чаті: мета, 2-3 обмеження і що перевірити першим. Перший підхід може бути discovery-планом, а не кодом./context і /compact
Команда /context показує, чим зайняте вікно.
Читайте її як відповідь на три питання:
- чи не з'їла історія діалогу все місце;
- чи не висять довгі невикористані логи;
- чи досі у фокусі потрібні файли й обмеження.
Команда /compact замінює детальну історію на summary, частина деталей губиться.
Тому стиснення корисно спрямовувати й прямо сказати, що зберегти.
/compact Збережи:
- мету й критерії приймання з task spec
- область змін: тільки src/auth/*
- відхилену гіпотезу: проблема не в SessionService
- наступний крок: перевірити рендер помилки в LoginController
І пам'ятайте: після стиснення не можна сперечатися "ти ж 20 хвилин тому казав" - у вікні тепер summary, факт піднімайте заново з файлу.
Стиснення трапляється і без вашої команди: коли вікно майже заповнене, Claude Code запускає auto-compact сам - наближення видно заздалегідь за індикатором виду "Context left until auto-compact" у рядку стану. Auto-compact - той самий /compact, тільки список "що зберегти" за вас ніхто не складе. Тому довгу сесію вигідніше стиснути самому на зручній межі, а не чекати, поки це станеться посеред кроку.
І про шари: після стиснення project-root CLAUDE.md, загальні rules і auto memory самі підвантажуються у вікно заново. А от rules, прив'язані до шляхів (path-scoped), і вкладені CLAUDE.md повернуться тільки коли Claude знову прочитає файл із потрібної області - як і вміст самих файлів: від прочитаного залишається рядок у summary, і перед наступною правкою його потрібно відкрити заново.
Що з'їдає вікно до першого питання
Вікно зайняте ще до того, як ви надрукували перше слово, - виглядає це приблизно так:
/context

  System prompt     3.2k   ( 2%)   службові інструкції
  System tools     12.1k   ( 6%)   описи вбудованих інструментів
  MCP tools        21.4k   (11%)   підключені зовнішні сервери
  Memory files      1.8k   ( 1%)   CLAUDE.md, rules, auto memory
  Messages         45.2k   (22%)   ваш діалог, файли, логи
  Free space      116.3k   (58%)
Точний вигляд виводу залежить від версії, а розмір вікна - від моделі. Але картина завжди одна, і з неї випливають практичні висновки:
- службовий мінімум - system prompt і вбудовані інструменти - є завжди, на нього ви не впливаєте;
- кожен підключений MCP-сервер додає свої описи, навіть якщо ви ним жодного разу не скористалися, - підключайте за потреби, а не "хай буде";
- розрослий
CLAUDE.mdоплачується заново в кожній сесії - ще один аргумент тримати його коротким; - у процесі роботи росте тільки messages - саме за цим рядком і варто стежити.
/context, попросіть прочитати пару файлів і запустіть ще раз - рядок messages виросте на очах.Забруднення контексту та відновлення
Коли сесія поводиться дивно, справа зазвичай не в тому, що "Claude сьогодні гальмує" (і так буває), а в накопичених у вікні сигналах, які заважають завданню. Це context pollution. Ознаки помітні раніше, ніж здається:
- повернення до вже відхиленої гіпотези;
- ігнор свіжих обмежень;
- величезний лог, вставлений повністю "про всяк випадок", - він тисне на кожне наступне міркування;
- суперечливі вимоги з різних ітерацій - модель намагається догодити всім одразу;
- застарілі docs або розрослий
CLAUDE.md, які сперечаються з реальним кодом.
Спочатку відділіть нестачу від забруднення: якщо Claude просить файл і ставить питання - додайте джерело. Якщо впевнено міркує на старому смітті - очищайте. І окрема дія, про яку забувають: якщо файли вже змінені, нічого не робіть, поки не прочитали diff.
Чарівної однієї кнопки немає, і кожен інструмент вирішує свій тип проблеми.
/context і подумайте, чи не час виконати /compact або вже завершувати сесію.Сесія як контейнер завдання
"Одна розмова на всі випадки життя" псує і контекст, і diff.
Те саме - продовжуємо;
те саме, але історії багато - стиснути;
змінилося - відкрити новий контейнер.
Команди керування:
/renameдає ім'я сесії;/resumeі--continueповертають до сесії;/branchі--fork-sessionвідводять гілку розмови;/exportвивантажує сесію у файл або буфер;claude --resumeбез аргументів відкриває session picker - список сесій, де найпростіше знайти потрібну за іменем.
Сесія - витратний контейнер, а не сімейна реліквія: вона живе рівно стільки, скільки допомагає одному завданню.
Довге завдання ламається в процесі
Довге завдання ламається не в коді, а коли процес втрачає форму: контекст розростається, гіпотези перемішуються, diff стає неможливо читати.
Запит "повністю відрефактори й зроби нормально" перетворюється на широку допомогу там, де ви її не просили. Щоб цього не сталося, завданню потрібен каркас, який відповідає на три питання:
- що саме робимо;
- чого не робимо;
- де зупиняємося перевірити.
Тому task spec довгого завдання одразу ділиться на етапи - milestones. Усередині такого коридору Claude працює по суті, а не блукає "заради краси", і завжди видно, де завдання перебуває.
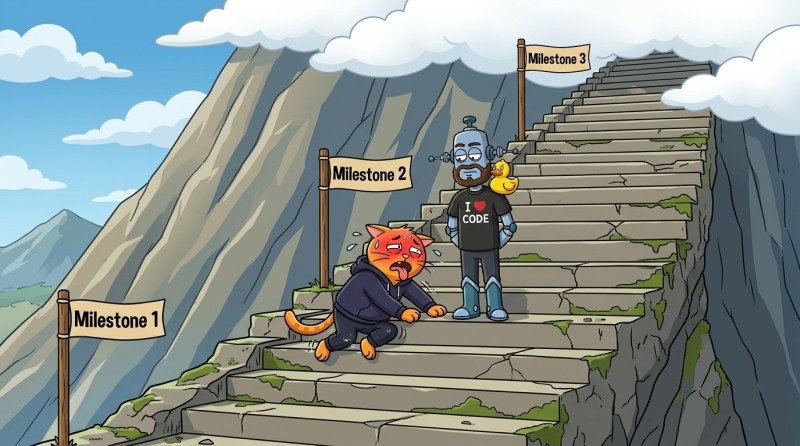
Кожен milestone закінчується коротким summary, перевірками й маленьким commit. Саме це робить довге завдання переносимим і перевірним.
Новий проєкт як довге завдання
Збірка проєкту з нуля - це теж довге завдання. Той самий довідник локалей і той самий каркас із milestones працює, тільки етапи тепер про побудову, а не про правку. Правило нарізки одне: кожен milestone закінчується робочим шматком, який можна перевірити, а не "половиною всього одразу":
- M1 - backend API і тести:
- що будуємо: серверну частину, яка за запитом віддає список локалей із готового набору даних, інтерфейсу поки немає взагалі;
- фініш: тести зелені - межу перевіряє машина, і це найнадійніший вид перевірки;
- M2 - UI зі списком локалей:
- що будуємо: сторінку, яка бере локалі в сервера з M1 і показує їх списком;
- фініш: відкрили браузер - список на місці; цю межу видно очима;
- M3 - пошук і фільтр:
- що будуємо: пошук по списку - фільтр за кодом, країною або мовою поверх уже робочого списку;
- фініш: фільтр працює вручну, а тест на фільтр зелений.
Порядок не випадковий: кожен етап спирається на перевірений попередній. Тому якщо на M3 щось зламалося, ви шукаєте проблему в пошуку й фільтрі, а не "десь у проєкті". А маленький commit на кожній межі скоро знадобиться: саме він дозволить відкотити невдалий M3, не чіпаючи корисні M1 і M2.
Діаграма показує суть дисципліни: вперед можна тільки через перевірку й commit, а невдача повертає всередину поточного етапу, не руйнуючи попередні.
Ім'я сесії, summary, stop points
Безіменна сесія після десяти хвилин починає працювати проти вас: з'являється "та довга про refunds" і "ще одна, але з тестами". Ім'я завдання, гілки й сесії в ідеалі збігаються. А зовнішня пам'ять завдання тримається на кількох простих речах:
- milestone summary - відповідає "де ми зараз";
- decision log - "що вже вирішено і не треба сперечатися заново";
- stop point - на межі milestone, а не через втому;
- маленький commit - фіксує стан файлів.
Хороший stop point - це місце, де завдання можна безпечно передати навіть майбутньому собі: зрозуміло, що зроблено, що перевірено і який наступний крок.
Context rot і два режими
Context rot - це забруднення на довгій дистанції: контекст старіє, і Claude тягне вже відхилені ідеї як актуальні. Лікування знайоме - зібрати summary і продовжити з чистого стану. Далі постає питання, як саме вести завдання, і тут є два режими:
- покроковий - крок, перевірка, рішення; для ризикованих змін, грошей, зовнішніх контрактів;
- goal-driven - ви формулюєте перевірну умову фінішу, і Claude працює кілька ходів поспіль, поки її не досягне.
Точна форма goal-driven залежить від версії: десь є команда /goal <умова> (а /goal clear знімає ціль), десь ту саму роботу робить явний prompt "працюй, поки тести в test/auth не стануть зеленими" - звіртеся з /help. Сам прийом від версії не залежить.
Goal-driven безпечний тільки за надійного детермінованого фінішу. Умову пишуть так, щоб результат було видно у виводі Claude: "тести в test/auth зелені" працює, бо Claude проганяє тести й результат потрапляє в розмову. На новій feature довідника фініш звучить так само просто: "тест на фільтр локалей зелений".
Розвилка проста: машинно перевірний фініш відкриває goal-driven, усе інше безпечніше вести покроково.
Checkpoint і /rewind
За відчуттям схоже, за наслідками ні: /rewind - це Undo в редакторі, а commit - збережена версія документа в repository. /rewind повертає до здорової розвилки всередині сесії: гілку розмови й часто пов'язані з нею правки файлів.
/rewind - страховка, а не основний workflow. База довгого завдання - git diff, маленькі commits і зрозумілий scope; /rewind використовуємо, поки помилка ще живе всередині сесії Claude.Але за межами його влади вже зроблений commit і тим більше зовнішні ефекти: база даних, deploy, відправлений запит. І ще один чесний сигнал: третій /rewind до однієї й тієї самої розвилки - не стратегія, а діагноз. Отже, виправляйте task spec і scope або відкривайте fresh session.
rm, mv, cp, скрипти), він не відстежує, і /rewind їх не поверне - для цього залишаються Git і бекапи.Механіка коротко: checkpoints створюються автоматично перед правками через інструменти Claude. В історію можна зайти через Esc+Esc або /rewind; у меню вибираєте, що повернути - розмову, код, обидва стани або зробити summary from here.
Що раніше ви помітите погану гілку, то вищий шанс, що вона ще живе тільки всередині сесії, де її й поверне /rewind.
Branch, session, worktree
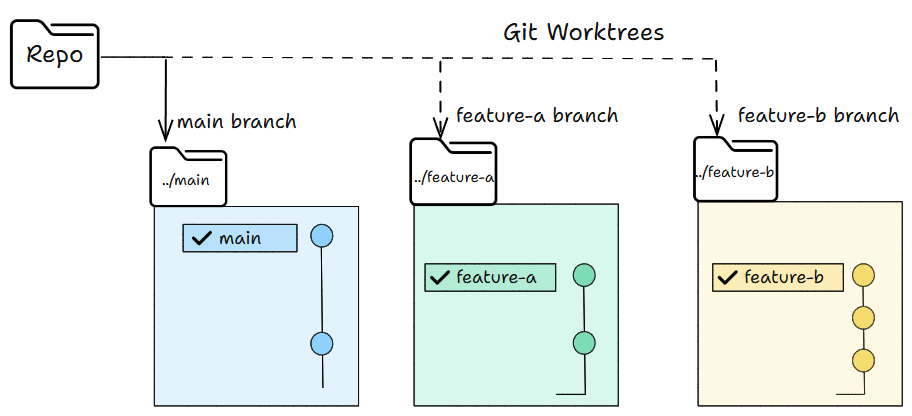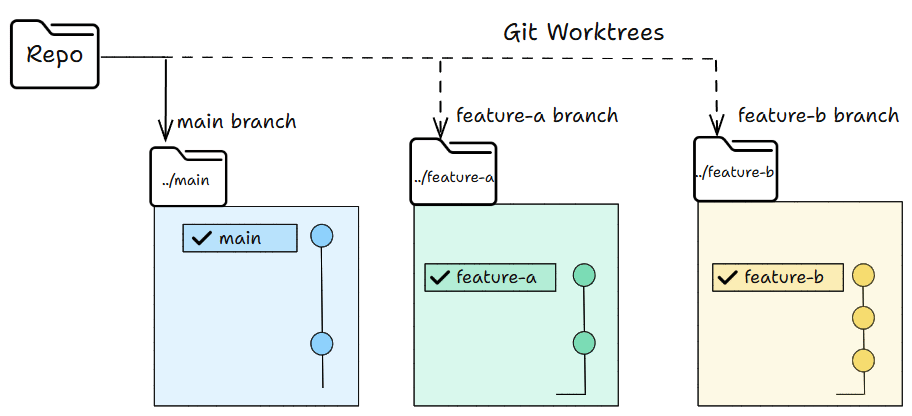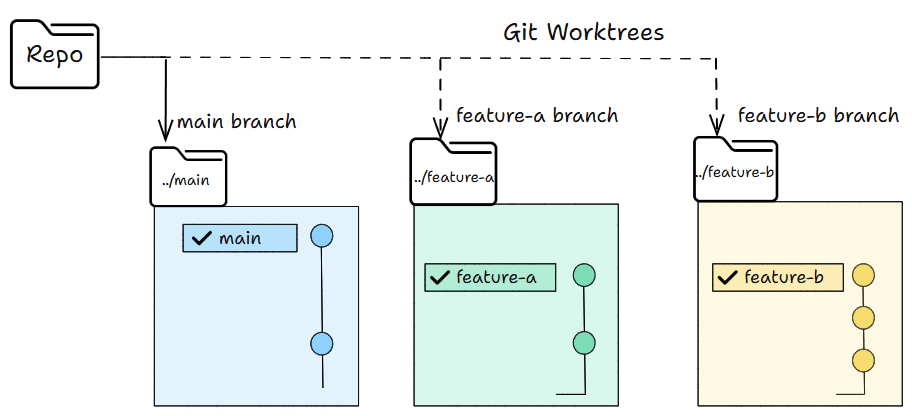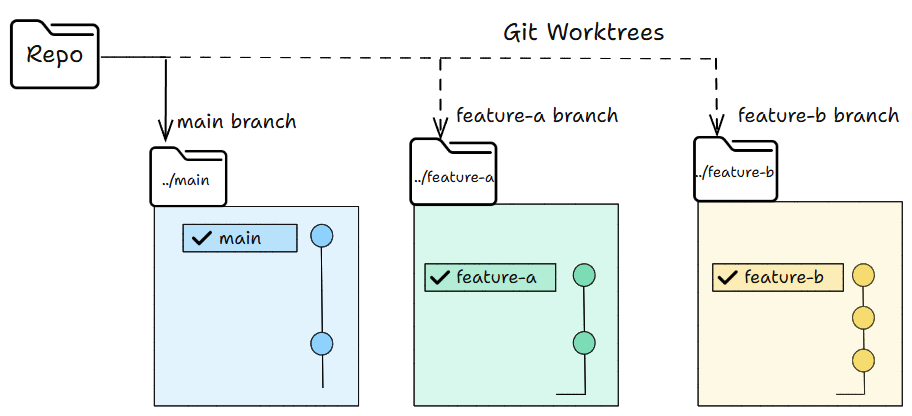
Гілка, сесія і worktree - це три різні шари однієї роботи, і їх легко переплутати:
- branch зберігає історію змін (Git);
- session зберігає контекст розмови (Claude Code);
- worktree зберігає окреме робоче місце (файлова система).
На схемі видно зв'язку: гілка дає worktree, у worktree відкривається сесія, а правки повертаються комітом у гілку. Шари пов'язані, але очищуються й ламаються по-різному - тому їх і дорого плутати.
Worktree - це друга тека того самого repository без повного клонування. Він доречний, коли в одному TASK_SPEC є незалежні шматки роботи: backend, UI, тести, міграції. Тоді основний agent, окремі сесії або subagents можуть працювати паралельно в різних worktree і не перетирати одні файли.
- коротка правка при чистому дереві - worktree зайвий;
- один потік правок - одна робоча тека;
- кілька незалежних потоків - різні worktree;
- у довіднику локалей після фіксації API-контракту з M1 backend і UI можна вести паралельно: вони вже не б'ються за одні файли.
Handoff і fresh reviewer
Фраза "начебто готово" не відповідає на жодне інженерне питання. Handoff працює інакше: HANDOFF_NOTE.md - це передбачуваний пакет, де потрібні речі лежать на очікуваних місцях:
- goal;
- changed files;
- decisions;
- tests/checks;
- known risks;
- next step.
Для маленької правки це може бути не окремий файл, а 5 пунктів у PR або issue. HANDOFF_NOTE.md потрібен, коли завдання переживає сесію, день роботи або передачу іншій людині.
Формулюйте сильно, а не розмито: не "тести зелені", а "запущено test, 8 passed"; next step - один конкретний крок, а не "продовжити роботу". Свіжий reviewer - нова сесія Claude або людина - перевіряє за цим пакетом, не як автор, і часто ловить пропущені edge cases, вихід за scope і недоведені твердження. Тільки не давайте йому все листування: інакше він заразиться старими гіпотезами, а потрібен свіжий погляд.
Handoff робить завдання незалежним від одного носія знання: його можна продовжити, перевірити або передати без археології по старому чату.
HANDOFF_NOTE.md на одну сторінку
Щоб handoff не залишився теорією, ось повністю заповнена записка для нашого довідника локалей - одразу після M2, коли список локалей уже видно в браузері:
# HANDOFF_NOTE.md

## Goal
Довідник локалей; завершено M2 - UI зі списком локалей з API.

## Changed files
- src/api/locales.js - endpoint GET /locales
- src/ui/locale-list.js - сторінка зі списком локалей
- src/data/locales.json - набір локалей (код, країна, мова, валюта)
- test/api/locales.test.js - тести API

## Decisions
- дані беремо з готового locales.json, а не з LLM - це довідкові факти
- стилі без UI-бібліотеки, звичайний CSS

## Tests / checks
- npm test: 8 passed, 0 failed
- вручну: список локалей видно на localhost:3000

## Known risks
- порожній результат пошуку не оброблено - сторінка виглядає "зламаною"

## Next step
M3: пошук і фільтр по списку + тест на фільтр
Зверніть увагу на формулювання: не "тести зелені", а "8 passed, 0 failed"; не "продовжити роботу", а один конкретний крок M3. Таку записку свіжа сесія Claude або колега читають за хвилину - і одразу працюють, а не відновлюють історію розкопками в чаті.
Практика - етап 1
Зберемо все на маленькому довіднику локалей. Перший крок - не код, а контекст, і prompt ви пишете самі: завдання в тому, щоб змусити Claude спочатку думати, а не чіпати файли.
Щоб завдання було конкретним, домовимося, що таке одна локаль - на прикладі Австралії:
- код локалі -
en-AU(ISO 639 мова плюс ISO 3166 країна); - мова й країна - English, Australia;
- валюта і TLD - AUD,
.au; - прапор країни;
- опційно - таймзона і столиця.
Цього мінімуму достатньо, щоб і список, і пошук спиралися на одні й ті самі поля.
Спочатку придумайте prompt самі
Мета: "хочу маленький довідник локалей, проєкту ще немає, потрібен план". Перш ніж друкувати, прокрутіть у голові:
- як прямо на початку не дати Claude одразу кинутися писати код?
- який контекст ви дасте замість файлів, яких ще немає?
- які технічні рамки задати, щоб Claude не притягнув зайвий framework?
- як змусити його розбити роботу на перевірні шматки?
- що попросити на виході, нічого поки не створюючи?
Наш варіант
Я хочу зробити маленький довідник локалей для навчального проєкту:
список локалей, у кожної - код (en-AU), мова, країна, валюта, TLD і прапор.
Проєкту поки немає. Спочатку склади план.
Стек простий: Node на backend, чистий HTML/CSS/JS на frontend, без frameworks і npm-залежностей.

Зроби:
1. Сформулюй короткий TASK_SPEC прямо у відповіді, файл поки не створюй.
2. Скажи, який контекст тобі потрібен від мене перед кодом.
3. Розділи роботу на 3 milestones.
4. Для кожного milestone напиши перевірний фініш.
5. Наприкінці переліч файли, які створив би, але поки нічого не створюй.Практика - етап 2
Тепер даємо Claude побудувати один milestone, і prompt знову ваш. Мета не весь проєкт, а M1 з перевіркою й маленьким commit.
Спочатку придумайте prompt самі
Рамка: тільки M1 - мінімальний backend API, який віддає список локалей із готового набору даних, і один тест на endpoint, без UI та пошуку. Подумайте:
- як утримати Claude рівно в одному milestone і не пустити в M2?
- що попросити показати до правок, щоб не схвалювати наосліп?
- чим перевірите результат - своїми руками й машиною?
Наш варіант
Тепер можна створити проєкт. Спочатку ініціалізуй repository: git init.

Працюй тільки над M1:
- мінімальний backend API, який віддає список локалей із готового locales.json;
- один тест, який перевіряє відповідь endpoint GET /locales;
- без UI, без пошуку, без авторизації.

Перед правками:
1. покажи план файлів;
2. назви критерій зупинки.

Після роботи, до commit:
3. покажи git diff і команду перевірки;
4. дочекайся мого "ок" і зроби маленький commit M1.

Зупинися після M1 і не переходь до M2 без мого підтвердження.
Якщо план M1 роздувся або поліз у сусідні теми, не запускайте реалізацію. Спочатку split: зменште M1 до одного перевірного фінішу, а решту винесіть у наступний milestone.
locales.json, а сервер нехай просто читає файл і віддає його на GET /locales - без бази даних і зайвих шарів. Що тонший backend на цьому кроці, то менша поверхня для bugs і то простіше написати тест на форму відповіді.Практика - етап 3
Останній крок - побудувати M2 і красиво передати роботу. Тут два prompts, і обидва ваші: спочатку план, потім handoff.
fetch із браузера не вперся в CORS, найпростіше, коли Node віддає і статику frontend - тоді сторінка й API на одному origin (localhost:3000). Frontend, відкритий як file://, до API не достукається.Спочатку придумайте prompts самі
Рамка: M2 - UI зі списком локалей з API M1, контракт M1 змінювати не можна, наприкінці потрібен HANDOFF_NOTE.md. Спочатку просіть план, файли не чіпати. Подумайте:
- як заздалегідь витягнути з Claude ризик виходу за scope?
- за якою ознакою вирішите: дозволити M2 чи відкотити через
/rewind? - що покласти в handoff, щоб свіжий reviewer зрозумів без читання чату?
Наш варіант
Продовжимо до M2, але спочатку склади план, файли не чіпай.

M2:
- UI зі списком локалей з API M1;
- контракт API з M1 змінювати не можна;
- наприкінці потрібен HANDOFF_NOTE.md.

Назви файли під правку, ризик виходу за scope і як мені перевірити diff.
План чистий - дозволяєте M2 і просите записку; лізе не туди - /rewind або переплан без правок.
Склади HANDOFF_NOTE.md для свіжого reviewer.

Додай:
- goal;
- changed files і роль кожного файла;
- decisions;
- tests/checks з точними результатами;
- known risks;
- один next step.

Не включай усю історію чату.UI-стартер для M2
Це необов'язкове доповнення до етапу 3. Щоб M2 виглядав не як "голий список із підручника", дайте Claude готовий зразок стилю й попросіть будувати UI на ньому. Це знову правило контексту зі слайда про порожній проєкт: дати зразок, а не "придумай красиво сам". Маленький starter задає tokens і пару класів - далі Claude повторює їх у таблиці локалей.
<!-- ui-starter.html: зразок стилю для M2 (структура + tokens, без JS).
     Прапори - flag-icons через CDN (fi fi-XX за ISO 3166), не з LLM -->
<link rel="stylesheet" href="https://cdn.jsdelivr.net/npm/flag-icons/css/flag-icons.min.css">
<style>
  :root { --bg:#0f172a; --card:#1e293b; --line:#334155; --text:#e2e8f0; --accent:#6366f1; }
  body { background:var(--bg); color:var(--text); font-family:system-ui,sans-serif; padding:24px; }
  .search { width:100%; margin-bottom:12px; padding:10px 14px; border-radius:10px;
            background:var(--card); color:var(--text); border:1px solid var(--line); }
  .locales { width:100%; border-collapse:collapse; }
  .locales th, .locales td { padding:10px 12px; text-align:left; border-bottom:1px solid var(--line); }
  .locales th { color:#8b98b1; font-size:13px; }
  .flag { font-size:20px; border-radius:3px; } /* масштаб через font-size */
  .code { font-family:ui-monospace,monospace; font-weight:700; color:var(--accent); }
</style>

<input class="search" placeholder="Пошук за кодом, країною або мовою">
<table class="locales">
  <!-- зразок рядка; живі рядки малює app.js із GET /locales -->
  <tr><th>Flag</th><th>Code</th><th>Language</th><th>Country</th><th>Currency</th><th>TLD</th></tr>
  <tr>
    <td><span class="fi fi-au flag"></span></td>
    <td class="code">en-AU</td><td>English</td><td>Australia</td><td>AUD</td><td>.au</td>
  </tr>
</table>
Starter - статичний зразок стилю без JS. У prompt просимо розкласти його на index.html і styles.css та додати тонкий app.js, який тягне список з API і малює рядки - так зразок перетворюється на живий UI, а структура залишається зрозумілою:
M2 - UI зі списком локалей з API M1. Starter - один файл ui-starter.html (додано):
статичний зразок стилю без JS, бери з нього tokens і класи, нових стилів не вигадуй.
Розклади UI на index.html + styles.css + тонкий app.js: app.js робить fetch GET /locales і малює рядки таблиці.
Прапори - з набору flag-icons за кодом ISO 3166 (class="fi fi-XX"), не з LLM.
Спочатку план файлів, контракт API не чіпай.Архітектура довідника цілком
Коли довідник зібраний, він складається в просту й зрозумілу картину - кожен шматок ви будували окремо:
Дані лежать у locales.json (M1), Node віддає їх по HTTP, а frontend на чистому HTML, CSS і JS читає API і малює список (M2). Пошук і фільтр (M3) ви доробляєте самі на тому самому каркасі milestones. Один контракт API зв'язує всі шматки - на ньому й тримається зібраний довідник.